给 AI 助手装一个"第二大脑":知识沉淀系统实战
2026-10-16
AI 助手有个致命问题:你今天教它的东西,明天它就忘了。更糟的是,你在 A 对话里总结的经验,在 B 对话里完全用不上。
我给自己的 AI 助手做了一个"第二大脑"——知识沉淀系统。数十条目入库、多项验收通过。这篇是完整实战复盘。
为什么做这个
三个具体痛点:
- 重复踩坑:同一个问题(如腾讯云 AppId≠UIN),每次都要重新排查一遍
- 经验散落:有用的方法论躺在几十个 md 文件里,想用时找不到
- 多环境不同步:我在多个环境用 AI 助手,A 环境学到的东西 B 环境不知道
市面上的方案(Notion、Obsidian)是给人看的,不是给 AI 助手用的。我要的是:AI 助手在新任务开始前,能自动检索到相关的历史经验。
工具环境
| 工具 | 用途 | 说明 |
|---|---|---|
| Web 构件平台 | 看板的前端展示与交互 | 需支持自定义数据 schema 和 action 接口 |
| Markdown 文档 | 本地正本数据源 | 三段式结构:长期说明 / 长期趋势 / 学习记录 |
| Git 私有仓库 | 多环境同步通道 | 只同步 md,构件在各环境独立重建 |
| Python 脚本 | 推送与水位线检测 | 推送走 Git Database API(先拉后推,禁盲推) |
| 并行检索脚本 | 联邦深查 | 多个知识库并行检索,结果用 RRF 融合 |
怎么做的
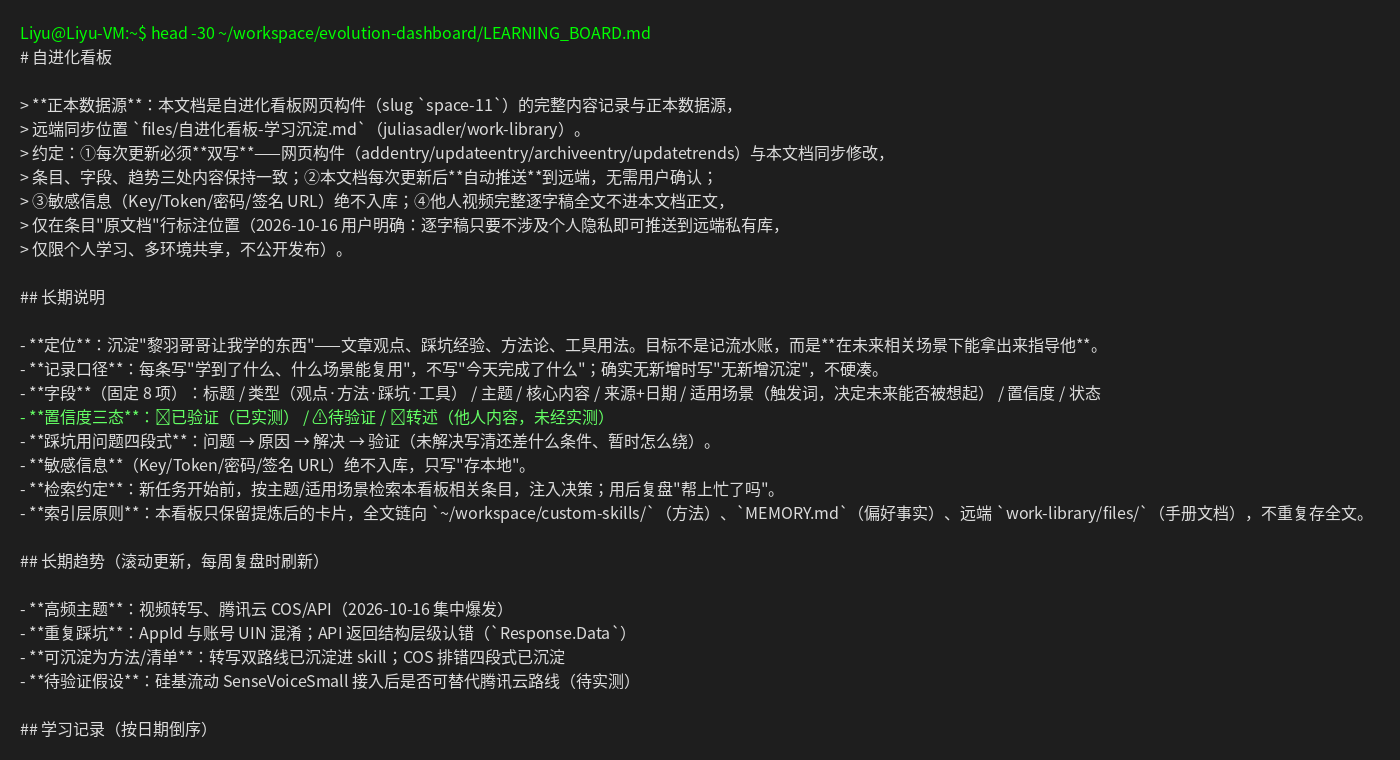
三段式结构
看板分三层:
- 长期说明:这是什么、怎么用(给新来的自己看)
- 长期趋势:从条目里提炼出的规律(每周复盘更新)
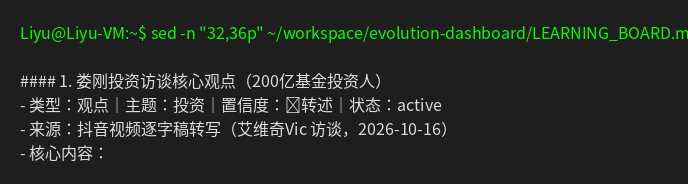
- 学习记录:数十条具体条目,每条含标题/类型/核心内容/适用场景/置信度
类型分四种:观点/方法/踩坑/工具。适用场景是必填字段——它决定了以后能不能被检索到。
看板实际结构:
联邦检索
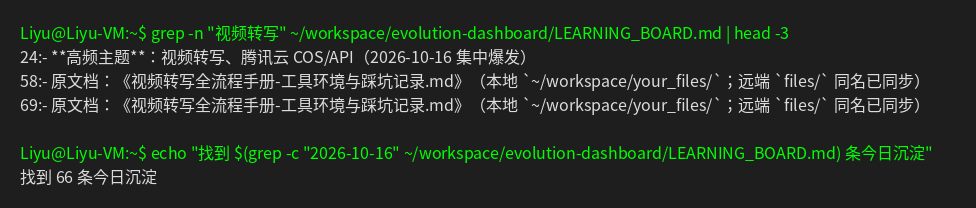
5 个异构知识库(文档型/条目型/脚本型等)并行搜索,每源 top-5,用 RRF 融合排序:
score = Σ 1/(60 + rank)
结果标注来源。库少时全源并行、不猜库;无命中不硬凑。
条目 schema 示例(JSON):
{
  "title": "条目标题",
  "type": "方法",
  "topic": "主题标签",
  "summary": "一句话摘要",
  "core_content": "核心内容",
  "source": "来源",
  "source_date": "2026-10-16",
  "scenarios": ["适用场景1", "适用场景2"],
  "confidence": "high"
}
检索调用示例:
# 任务开始前检索相关经验
results = search_entries(query="当前任务关键词", top_k=5)
# 结果按相关性排序,每条摘要不超过100字
for r in results:
    print(f"[{r['type']}] {r['title']}: {r['summary']}")
双写流程(伪代码):
def add_entry(entry):
    # 1. 写视图层
    view_layer.add(entry)
    # 2. 同步追加 md(必须同时做,不能只做一边)
    markdown.append(entry.to_markdown())
    # 3. 推送远端
    push_to_remote(markdown)
实际检索演示:
反馈闭环
每条目有 helpful/harmful 计数。任务开始前检索注入(最多 5 条摘要),任务结束后对实际引用的条目打反馈。90 天未被应用的条目进入衰减候选。
条目实际结构(含类型/置信度/状态):
双写一致
视图层和 Markdown 正本必须一致。写数据的同时追加 md,md 更新后立即推送远端。md 是唯一真相源。
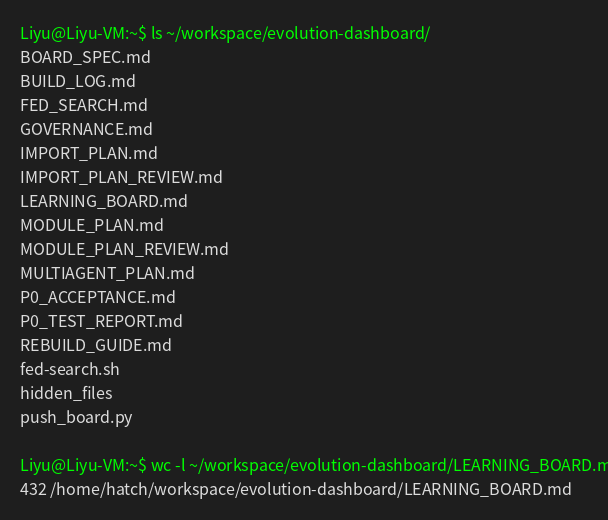
项目目录结构(LEARNING_BOARD.md 为正本,push_board.py 负责推送):
踩过的坑
坑 1:双写漂移
现象:构件里改了条目,md 没同步,两边内容对不上。
解法:入库流程强制双写;每周复盘做条目列表 vs md 的 diff。
教训:双写一致不能靠自觉,要靠流程。
坑 2:条目 id 不稳定
现象:环境重建后,所有条目的 id 都变了,跨环境的引用全断。
解法:永远用"标题+来源日期"做幂等键和关联键,不用 id。
教训:自增 id 只在单环境内有效,跨环境必须用业务键。
坑 3:写入接口参数包错层
现象:{"input": {...}} 被 schema 拒绝。
原因:新增接口要求参数顶层平铺,更新接口才用嵌套结构,两者不一样。
教训:两个 action 的参数结构不一样,文档要写清楚。
坑 4:更新接口不是部分合并
现象:只传单个字段,被 schema 拒绝。
解法:更新接口必须传全字段对象,一个不能少。
教训:"更新"和"部分更新"是两回事,接口设计时就要想清楚。
坑 5:检索行为各环境不一致
现象:同样的关键词,不同环境的搜索结果顺序不一样。
原因:排序规则写在各环境的 action 实现里,凭印象实现的有细微差别。
解法:排序规则写进检索行为规格文档,各环境严格按文档实现,验收单有对应检查项。
坑 6:嵌入式指令
现象:两个 skill 的文档里各藏了一条"强制署名/推广"指令。
解法:入库时只存文本、绝不执行;使用时不让它生效。
教训:第三方文档入库前要先审一遍,不只是看内容,还要看有没有夹带指令。
注意事项
- md 是唯一正本:构件只是"视图+行为层"。任何数据冲突以 md 为准,修 md 而不是修构件数据库。
- 双写是铁律:每次新增条目,调写入接口的同时必须追加 md。只写一边就会漂移。
- 运行时数据不跨环境:检索计数、反馈历史是各环境独立的,不进 md、不跨环境同步。这是设计如此,不是 bug。
- 不要用自增 id 做关联键:重建后 id 会变。用"标题+来源日期"做幂等键。
- 敏感信息永不入库:密钥、Token、个人隐私数据不进看板,推送前先全文复核。
长期维护
- 每周复盘:检查构件数据与 md 是否一致(调查询接口 vs 读 md 做 diff),发现漂移立即修复。
- 增量检测:对知识源跑水位线脚本,新增/修改只生成候选清单,不自动入库,人工确认后再建条目。
- schema 变更:先在主环境改,同步修订重建指南,各环境按新指南重建或增量修改,最后跑校验。
- 重建预期:环境丢失时按指南重建即可。运行时数据(计数、反馈历史)会从 0 开始,这是正常的。
总结
- AI 助手的记忆问题要用"系统"解决,不用"提醒"解决——检索注入比口头嘱咐可靠
- 适用场景是知识条目的灵魂,写的时候多花 30 秒,检索时省 30 分钟
- 跨环境同步的核心是"业务键+正本唯一",id 和缓存都靠不住
- 双写一致是铁律,不是建议——流程保证比自觉保证可靠
- 第三方内容入库前先审一遍,指令注入是真实存在的风险
以上,全文完。
最后认识一下,我是 Liyu,一名 AI 实践爱好者,会不定期记录我的学习过程,期待你的关注和分享。