AI 视频生成实战全解:从提示词到后期的 7 个关键结论
2026-10-17
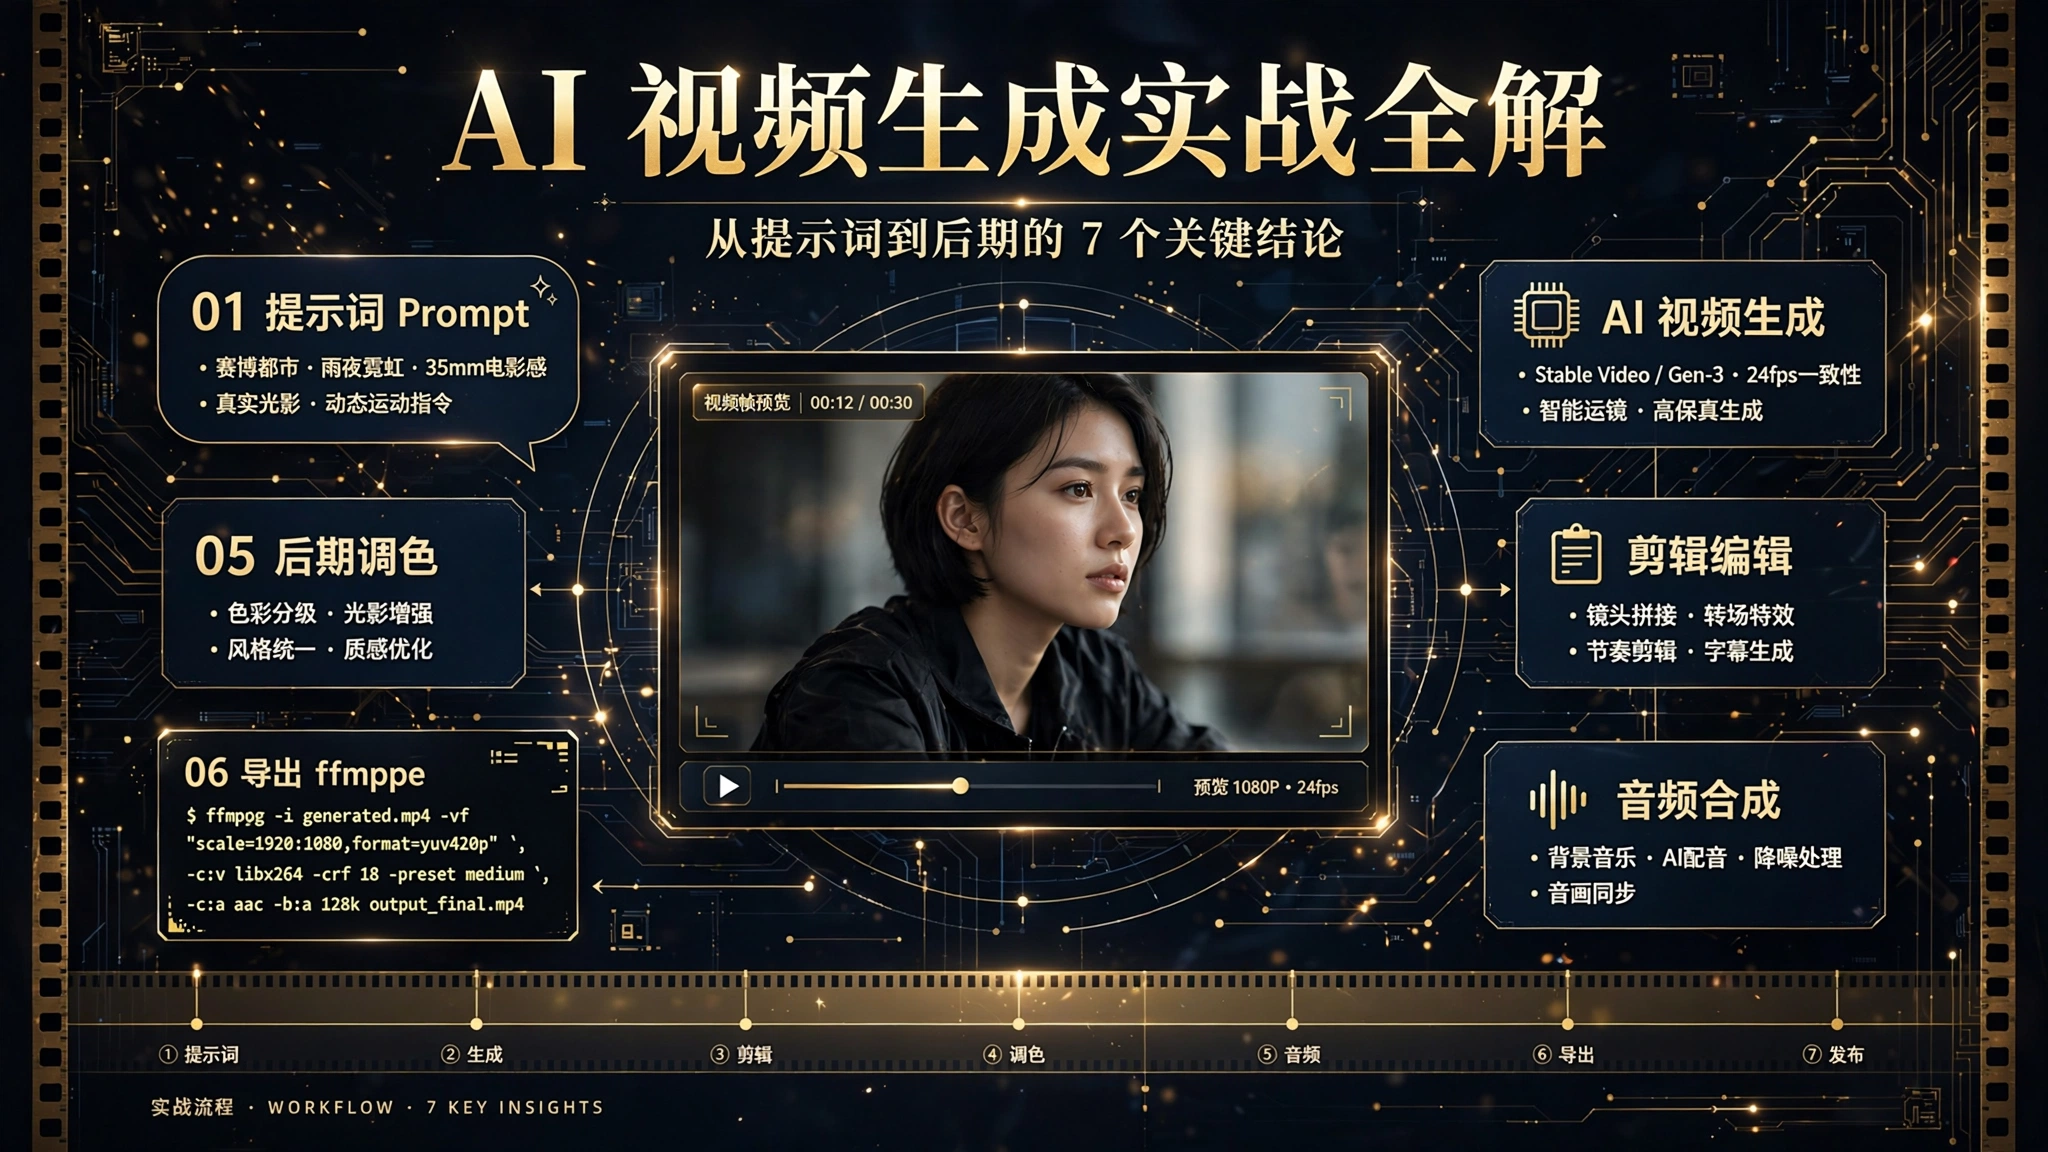
用 AI 生成了 20 多条人物视频后,我发现一个残酷的真相:提示词写得再好,模型也只是在"尽力配合",而不是"精确执行"。
这篇把两周实测中 7 个最有价值的结论一次讲透:从提示词写作、首尾帧锚定,到后期晃动配方。每个结论都是"现象→原因→解法→验证"四段式,附可直接复制的参数。
先说结论:提示词只能引导,不能保证
这是最重要的认知,没有之一。
我用完全相同的提示词(含 no blinking 约束)生成了 v7 和 v8 两个版本:
- v7:10 秒零眨眼,完美符合要求
- v8:一次自然眨眼,无视了约束
原因:扩散视频模型是概率采样,不是确定性渲染。提示词影响的是概率分布,不是硬约束。no blinking 只是把"眨眼"的概率压低,不是归零。
解法:
- 重要镜头多抽几次,择优选用(我一般抽 3-4 条选最好的一条)
- 10 秒长镜头切成三段,逐段挑选
- 真的需要精确控制(比如眨眼次数必须为零),换参数化路线:FaceFusion 的 eye_open_ratio、3D 虚拟人
验证:v7/v8 对照实测,同一提示词不同结果,确认是概率行为非 bug。
记住这句话,后面所有技巧都是在这个认知框架下的"概率优化",不是"精确控制"。
工具环境
| 工具 | 用途 | 说明 |
|---|---|---|
| media.generate_video | 视频生成 | Muse 自有模型,每段约 10 秒,单消息上限 6 条 |
| ffmpeg | 后期处理 | 拼接、加晃动、统一分辨率 |
| 人物参考图 | 一致性 | 每段生成都要传,否则人物会漂移 |
模型实测规格(2026-10-16 实测): - 每段约 10 秒,自带按提示词生成的音频 bed(非静音) - 各段分辨率可能不一致(如 608×1376 vs 720×1280),拼接前必须统一 scale+crop - 人物参考图每段必传,一致性才稳
结论一:提示词通用骨架——六段式
现象:网上提示词教程五花八门,不知道按什么顺序写。
原因:没有结构化的写作框架,东拼西凑容易漏掉关键约束。
解法:用六段式骨架,顺序固定:
[人物] + [动作] + [环境] + [运镜] + [质感] + [否定约束]
举例(白墙自拍,实测通过):
[人物] 年轻亚洲男性,短发,穿白色T恤
[动作] 对着镜头微笑,头部保持静止
[环境] 纯白墙面背景,柔光
[运镜] 固定机位,中景
[质感] 电影感,浅景深
[否定约束] Avoid: mouth opening, sighing, camera shake, background change
验证:白墙自拍 4 段、轮渡复刻 2 条,均用此骨架一次通过。
结论二:首尾帧锚定——同一张图用两次的技巧
现象:图生视频时,想让首尾构图一致,但传两次相同图片路径会报错 duplicate input file path。
原因:模型做了输入去重校验,相同路径被判定为重复输入。
解法:把同一张图复制一份换文件名,分别作为首帧和尾帧传入:
cp 首帧.png 尾帧.png
# 顺序:[image(首帧), text, image(尾帧)]
media.generate_video([
    {"image": "首帧.png"},
    {"text": "人物保持静止,眨眼自然..."},
    {"image": "尾帧.png"}  # 同一张图,不同文件名
])
验证:咖啡馆 v6/v7/v8/v9、阳台 v1-v6 均用此法,构图锁定稳定、眨眼自然、无背景加料。
适用场景:图生视频保真度要求高的镜头;首尾构图需一致的短视频。
结论三:多余动作要单独点名——模型不会自己收敛
现象:v8 提示词锁了眼睛、头部、姿势,唯独没提嘴,结果模型加了约 1 秒的叹息。
原因:模型不会"举一反三"。你约束了 A、B、C,它不会自动推导出 D 也不该动。没提到的部位,模型认为是"自由发挥区"。
解法:每个可能异动的部位都要单独点名:
# v9 修正版(10 秒零叹息)
lips remain gently closed with no mouth movement
Avoid: mouth opening, sighing, lip movement
验证:v8(未约束嘴部)→ 有叹息;v9(单独约束嘴部)→ 10 秒零叹息。对照实测通过。
推广:眉毛、肩膀等部位如有异动,同理单独点名。写提示词时做"部位扫描":眼、眉、嘴、头、肩、手、身体、背景,逐个确认是否需要约束。
结论四:breathing 会被具象化成叹气
现象:v8 提示词写了 only soft breathing,结果得到约 1 秒的叹息。
原因:模型把 breathing 理解成"可见的呼吸动作"(叹气式呼气),而不是生理性的无感呼吸。英文词在模型的 latent space 里关联的是"动作",不是"状态"。
解法:三选一
1. 换成 breathing imperceptible(强调不可感知)
2. 直接删除,只留 holds still
3. Avoid 列表加 breathing motion
验证:阳台 v4/v5/v6 批量三版测试,改法后均无叹息。
教训:提示词里的每个词都要想一下"模型会怎么具象化它"。抽象词(breathing、natural、soft)是重灾区,能用具体描述就不用抽象词。
结论五:晃动后置——别让模型演手持
现象:想要 Live 实况的手持感,直接在提示词写 handheld camera,结果模型运镜漂移、背景加料,完全不可控。
原因:回到第一个结论——模型对运镜的控制是概率性的。手持晃动这种高频细节,模型根本做不到精确。
解法:生成时用 locked 相机只管保真,后期用 ffmpeg 加可控晃动:
# 配方:先放大 1.03 留余量 → 微旋转 → 动画裁剪窗口 → 回到原尺寸
# 672×1216 示例
ffmpeg -i input.mp4 -vf \
  "scale=690:1236,\
   rotate='0.0015*sin(2*PI*t*0.7)':fillcolor=black,\
   crop=672:1216:x='9+3*sin(2*PI*t*0.8)+1.5*sin(2*PI*t*2.17)':y='10+2.5*cos(2*PI*t*1.13)+1.2*cos(2*PI*t*2.71)'" \
  -c:a copy output_shake.mp4
关键细节: - 正弦频率用不成整数倍的组合(如 0.8/2.17),避免机械感 - 换分辨率按比例缩放振幅(832×992 已验证等比参数) - 先放大再裁剪,全程无黑边
验证:v7-shake、v9、阳台 v2/v3/v5 均验证通过——幅度频率精确可调、零漂移、模型无加料机会。
适用场景:AI 生成 Live 实况视频要手持感;模型运镜不可控、易漂移加料时。
结论六:多段拼接前必须统一分辨率
现象:4 段视频直接 ffmpeg concat,报错或画面跳动。
原因:各段分辨率不一致(实测:608×1376 vs 720×1280)。模型每段是独立采样的,不保证分辨率一致。
解法:拼接前统一 scale+crop 到同一尺寸:
# 先统一到 720×1280
for f in v1.mp4 v2.mp4 v3.mp4 v4.mp4; do
  ffmpeg -i $f -vf "scale=720:1280:force_original_aspect_ratio=increase,crop=720:1280" -c:a aac ${f%.mp4}_uniform.mp4
done

# 再拼接
ffmpeg -f concat -safe 0 -i list.txt -c copy final.mp4
验证:白墙自拍 4 段拼接成片实测通过。
结论七:时长也只能引导——用 ffmpeg 精确截取
现象:v9 提示词写了 3 秒,模型给了 10 秒。
原因:同结论一,时长也是概率采样。模型有个"默认时长偏好"(约 10 秒),提示词的时长要求只是弱引导。
解法:接受 10 秒的默认值,用 ffmpeg 精确截取需要的片段:
# 从第 2 秒开始截 3 秒(无重编码,速度快)
ffmpeg -ss 2 -i input_10s.mp4 -t 3 -c copy output_3s.mp4

# 需要精确到帧时重编码(避免关键帧断裂)
ffmpeg -ss 2 -i input_10s.mp4 -t 3 -c:v libx264 -crf 18 -c:a aac output_3s.mp4
验证:v9 的 10 秒成片用 -ss 2 -t 3 截取,3 秒片段流畅无断裂。
总结
- 提示词只能引导,不能保证——这是所有技巧的认知基础,重要镜头多抽几次择优
- 六段式骨架:[人物]+[动作]+[环境]+[运镜]+[质感]+[否定约束],顺序固定不遗漏
- 首尾帧锚定:同一张图复制改名,绕过 duplicate 校验,构图锁定
- 多余动作单独点名:模型不会举一反三,没提到的部位就是自由发挥区
- 警惕抽象词:breathing 会被具象化成叹气,能用具体描述就不用抽象词
- 晃动后置:生成时锁死相机保真,后期 ffmpeg 加可控晃动,附可直接复制的配方
- 拼接前统一分辨率:各段分辨率可能不一致,先 scale+crop 再 concat
以上,全文完。
最后认识一下,我是 Liyu,一名 AI 实践爱好者,会不定期记录我的学习过程,期待你的关注和分享。