联邦检索实战:5 个知识库并行搜索+RRF 融合
2026-10-16
5 个知识库,每个的格式、检索方式都不一样。用户问一个问题,我要从 5 个库里找答案,怎么排?
我的方案:全源并行检索,每源取 top-5,用 RRF 融合排序,结果标注来源。
为什么做这个
痛点很具体:
- 知识库 A 是 md 文件(grep 能查)
- 知识库 B 是结构化条目(关键词检索)
- 知识库 C 是外部脚本(调命令行)
- 各库的"相关度"分数不可比——A 的 0.9 和 B 的 0.9 不是一回事
传统 RAG 方案是把所有文档 embedding 后放进向量库。但我的库是异构的、动态增长的,不想为了检索再建一套索引。
工具环境
| 工具 | 用途 | 说明 |
|---|---|---|
| 看板检索接口 | 第一路检索 | 关键词检索,支持 top_k 参数;排序规则:标签命中 > 标题命中 > 内容命中 |
| 并行检索脚本 | 第二路深查 | 多个知识库并行检索,每源 top-5,输出统一 JSON(corpus/标题/摘要/来源) |
| RRF 融合算法 | 结果融合 | 公式:score(doc) = Σ 1 / (60 + rank),对文档在每路结果中的排名求和 |
怎么做的
架构
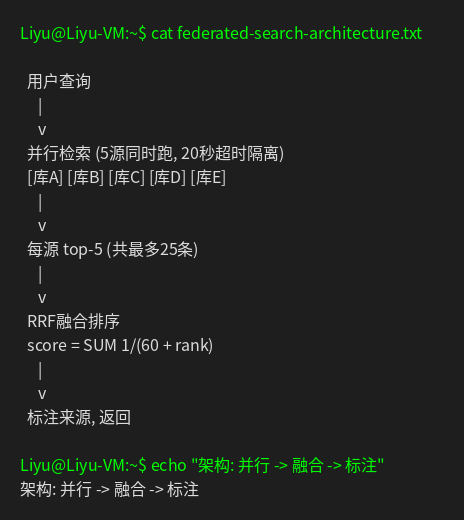
用户查询
    ↓
并行检索(5 源同时跑,20 秒超时隔离)
    ↓
每源 top-5(共最多 25 条)
    ↓
RRF 融合排序
    ↓
标注来源,返回
RRF 融合
Reciprocal Rank Fusion,核心公式:
score(doc) = Σ 1 / (k + rank_i)
其中 k=60 是常数,rank_i 是该文档在第 i 个源中的排名。
为什么用 RRF 不用加权平均?因为各源的分数不可比,但排名可比。RRF 只用排名,不用原始分数,天然适合异构源融合。
实现代码:
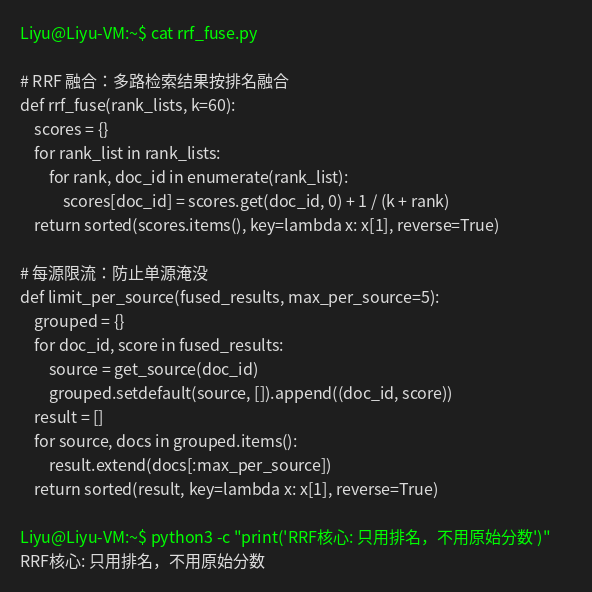
# RRF 融合:多路检索结果按排名融合
def rrf_fuse(rank_lists, k=60):
    scores = {}
    for rank_list in rank_lists:
        for rank, doc_id in enumerate(rank_list):
            scores[doc_id] = scores.get(doc_id, 0) + 1 / (k + rank)
    return sorted(scores.items(), key=lambda x: x[1], reverse=True)

# 每源限流:防止单源淹没
def limit_per_source(fused_results, max_per_source=5):
    grouped = {}
    for doc_id, score in fused_results:
        source = get_source(doc_id)  # 每条结果带来源标识
        grouped.setdefault(source, []).append((doc_id, score))
    result = []
    for source, docs in grouped.items():
        result.extend(docs[:max_per_source])
    return sorted(result, key=lambda x: x[1], reverse=True)
检索策略
- 库少时全源并行:不猜用户想查哪个库,5 个全查
- 每源 top-K:K=5,太多噪音,太少漏检
- 结果标注来源:每条结果标注来源库,用户知道答案从哪来
- 无命中不硬凑:都没命中就返回空,不编造
- 单源失败隔离:某个源超时/报错,不影响其他源(20 秒超时)
何时走深查
关键词检索是第一层。如果命中不足或用户要"深入了解",走第二层深查:
- 结构化条目 → 读全文
- 索引卡 → 按
deep_search指引调用对应工具 - 外部库 → 调专用检索脚本
踩过的坑
坑 1:muse.write 吃 heredoc 缩进
现象:bash 脚本里的缩进和 [ ] 前空格被吃掉,脚本跑不起来。
解法:脚本用 cat <<'EOF' 经 exec 写入,并 bash -n 校验。
教训:写文件工具和 shell 的转义规则要分开看。
坑 2:单源阻塞拖死整体
现象:某个源的检索脚本 hang 住,整个检索等它超时。
解法:每源独立 20 秒超时,超时直接返回空,该源记为失败。
坑 3:结果去重
现象:同一内容在多个库都有,融合后重复出现。
解法:RRF 融合前先按内容哈希去重,保留排名最高的那个。
坑 4:top-K 选多少
现象:K=10 时噪音太多,K=3 时经常漏掉关键条目。
解法:实测 K=5 是平衡点。库 >10 或单库 >500 文档时再考虑语义路由。
注意事项
- 先查看板,再决定是否深查:看板已有 3 条以上高相关结果且用户没要求深挖,就不用跑深查(省时间)。
- 单源失败不影响其他源:并行检索时单个源超时或失败,其他源继续跑。给每个源设独立超时(如 20 秒)。
- 每源限流防淹没:融合后按来源分组,每源最多保留 5 条,防止某个噪声源的结果淹没其他源。
- 每条结果必须标来源:让读者知道这条结果来自哪个知识库,方便追溯和验证。
- 无命中不硬凑:两路都查不到就如实说"没找到",不要编造结果。
- 深查全程只读:不写远端、不修改任何知识库。检索是只读操作。
长期维护
- 检索效果反馈闭环:每次检索后记录"有没有帮上忙"(helpful/harmful),定期看哪些查询经常无命中,针对性补充知识库内容。
- 深查源健康检查:定期验证每个检索源是否可用。某个源长期失败要排查是路径变了还是权限问题。
- RRF 参数调优:k=60 是经验值。如果某类查询效果不好,可以试不同的 k 值,用反馈数据验证。
- 索引卡维护:大知识库用索引卡指向深查工具,而不是把全文灌进看板。索引卡的指引要随知识库结构变化而更新。
总结
- 异构源融合用 RRF,不用加权平均——排名可比,分数不可比
- 并行+超时隔离是标配,单源故障不能拖死整体
- 结果必须标注来源,可追溯比"看起来智能"更重要
- 无命中不硬凑,承认"不知道"比编造答案更负责
- top-K 是经验值,先实测再定,不要拍脑袋
以上,全文完。
最后认识一下,我是 Liyu,一名 AI 实践爱好者,会不定期记录我的学习过程,期待你的关注和分享。